Toda chamada paga feita para um pedido que uma regra interna recusaria é dinheiro gasto para descobrir o que a operação já sabia. E todo pedido que some porque uma API parceira saiu do ar no meio do processo é um cliente que já tinha decidido comprar e vai comprar em outro lugar.
Quase toda operação depende hoje de serviços que ela não controla: gateway de pagamento, transportadora, emissor de nota fiscal, consulta cadastral, assinatura eletrônica, modelo de IA. Os dois problemas acima costumam ter a mesma origem: o sistema foi montado como uma sequência de chamadas a esses serviços, na ordem em que cada integração foi contratada. Enquanto todos respondem rápido, ninguém percebe. Na primeira tarde em que o gateway demora ou a consulta cadastral fica fora do ar, a fila de pedidos trava junto.
Por que o sistema trava quando um parceiro demora
Num fluxo sequencial, o pedido só avança quando a chamada anterior responde. Se a tela de finalização espera a consulta cadastral para continuar, o cliente espera junto. Se a resposta não vem, ele vê uma mensagem de erro, tenta de novo ou desiste, e, conforme o envio foi construído, o pedido nem chega a ser gravado.
O efeito não fica restrito a um pedido. O capítulo sobre falhas em cascata do livro de engenharia de confiabilidade do Google descreve o mecanismo: quem chama um serviço consome recursos enquanto espera a resposta, e um serviço lento acumula chamadas paradas até derrubar quem depende dele. Na operação, isso aparece como a tarde em que “o sistema ficou lento” e ninguém consegue dizer quais pedidos entraram.
A correção começa separando duas coisas que o fluxo sequencial mistura: receber o pedido e processar o pedido.
Grave primeiro, processe depois
O pedido é gravado no momento do envio, com tudo o que o cliente preencheu, e a confirmação aparece na hora. As chamadas aos parceiros acontecem em seguida, fora da tela do cliente: cada uma vira uma tarefa que o sistema executa, registra e, se falhar, executa de novo.
É o desenho que usamos nos sistemas e integrações que colocamos em produção: o envio do pedido não depende da resposta de nenhum parceiro externo, e o pedido aparece para a equipe antes de a primeira chamada terminar.
Duas consequências práticas:
- Pico de acesso deixa de derrubar o formulário. Quando muitos pedidos entram ao mesmo tempo, as chamadas esperam numa fila e são processadas no ritmo que cada parceiro suporta.
- Nenhum pedido depende da memória de alguém. Se uma chamada falha, o pedido continua gravado, com a etapa e o motivo à vista da equipe.
Ordene as chamadas pelo custo, não pela ordem de contratação
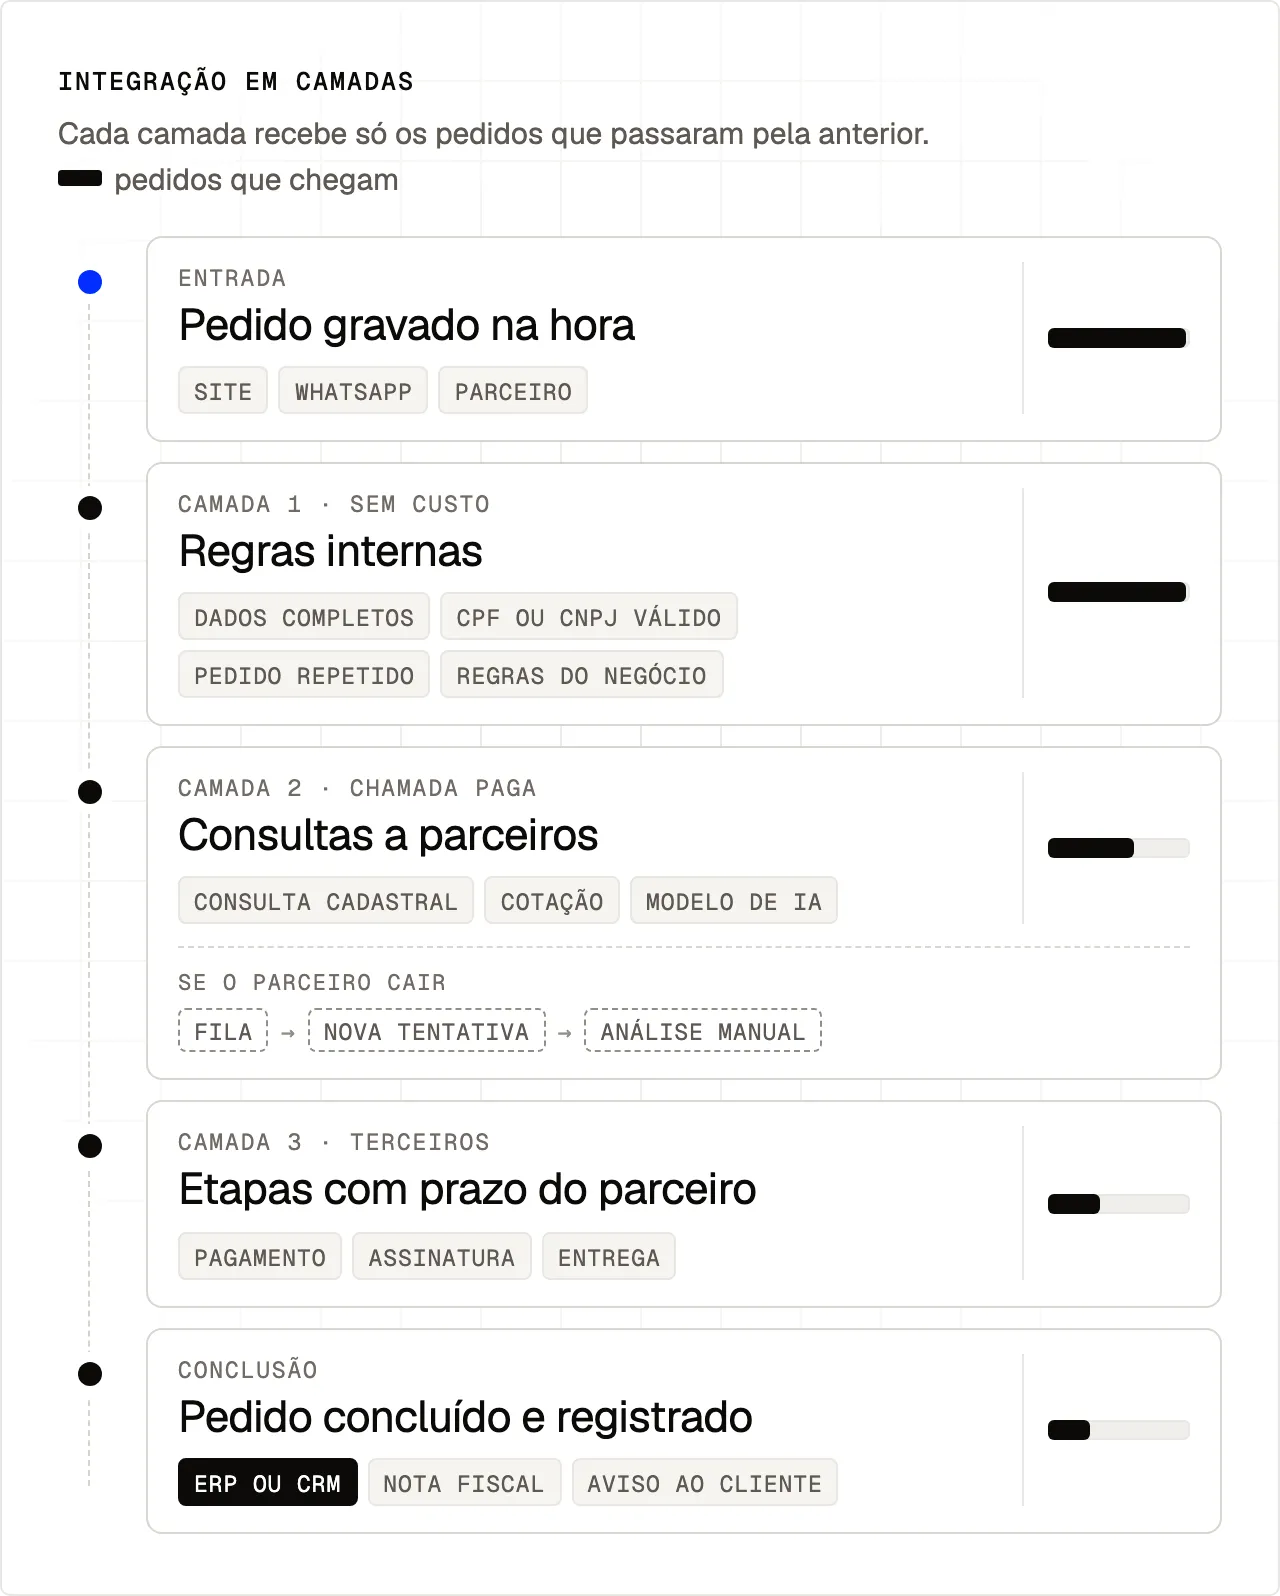
Num fluxo em camadas, as perguntas mais baratas vêm primeiro, e cada camada só recebe o pedido que passou pela anterior.
| Camada | O que verifica | O que custa |
|---|---|---|
| Regras internas | Dados completos, CPF ou CNPJ válido, pedido repetido, regras do próprio negócio | Nada: roda no próprio sistema |
| Consultas pagas | Consulta cadastral ou de crédito, cotação, análise por modelo de IA | Cada chamada é cobrada |
| Etapas com terceiros | Pagamento, assinatura, entrega | O prazo é do parceiro |
| Conclusão | Registro no ERP ou no CRM, nota fiscal, aviso ao cliente | Só roda com o pedido completo |
Regra de corte não é decisão automática sem critério. É a regra que a operação já tem, escrita antes e aplicada sempre do mesmo jeito: se o CNPJ é inválido ou o mesmo cliente já tem um pedido em andamento, nenhuma chamada paga muda essa resposta.
O mesmo vale para a inteligência artificial. A Anthropic, por exemplo, cobra o uso dos seus modelos pelo volume de texto processado, medido em tokens, na entrada e na saída. Uma automação que manda toda mensagem ao modelo, inclusive as que uma regra simples resolveria, paga por respostas que o sistema já sabia dar.
O pedido repetido merece atenção à parte. O mesmo cliente costuma entrar mais de uma vez, por canais diferentes: o site, o WhatsApp, um parceiro. Na automação de atendimento multicanal que publicamos entre os nossos cases, esse era um dos problemas de partida: o mesmo cliente acabava cadastrado duas vezes. A solução foi reconhecer quem já está na base e atualizar o cadastro existente em vez de criar um novo. Antes de uma chamada paga, a mesma checagem evita pagar duas vezes pela mesma pessoa.
Quando a chamada envolve dados pessoais, como uma consulta de CPF, a ordem das camadas também conversa com a LGPD: o princípio da necessidade (art. 6º, III) limita o tratamento de dados pessoais ao mínimo necessário para a finalidade. Consultar os dados de quem a própria regra recusaria é tratar um dado que não precisava ser tratado.
Faça a conta com os seus números: pedidos por mês × custo médio das chamadas pagas por pedido × parcela que uma regra interna recusaria. O resultado é o que a operação paga hoje para consultar quem nunca seguiria adiante.
Parceiro fora do ar não pode virar pedido perdido
Todo parceiro externo vai falhar em algum momento: o gateway de pagamento, a transportadora, o emissor de nota, a consulta cadastral. O sistema precisa saber o que fazer antes de isso acontecer. Quatro regras resolvem a maior parte dos casos:
- Tempo máximo de espera. Nenhuma chamada espera indefinidamente. Passado o limite, ela é tratada como falha e segue para nova tentativa.
- Nova tentativa espaçada e com limite. Repetir na hora, em sequência, sobrecarrega ainda mais um parceiro que já está com problema. A Amazon e o Google recomendam intervalos crescentes entre as tentativas, com uma variação aleatória, e o Google acrescenta um limite de repetições por pedido.
- Repetir sem duplicar. A nova tentativa não pode criar um segundo pedido, cobrar o cartão duas vezes nem pagar a mesma consulta de novo. É o que se chama de idempotência: a Stripe, por exemplo, associa cada operação a uma chave única, e a requisição repetida depois de uma falha de conexão não cria um segundo registro. Na prática, cada chamada leva a identificação do pedido e da etapa, e o sistema verifica se ela já foi feita antes de repetir.
- Tentativas esgotadas vão para uma pessoa. Depois do limite, o pedido entra numa fila de análise manual com o motivo descrito, e não num registro de erro que ninguém lê.
Para a equipe, tudo isso aparece como situação do pedido, nunca como erro técnico:
| O que aconteceu | O que a equipe vê | O que o sistema faz |
|---|---|---|
| A API parceira não respondeu | Aguardando parceiro | Tenta de novo, em intervalos crescentes |
| O parceiro voltou | O pedido avança de etapa | Retoma de onde parou, sem repetir o que já foi feito |
| As tentativas acabaram | Análise manual, com o motivo | Avisa o responsável pela fila |
| O cliente reenviou o formulário | Um pedido só, atualizado | Reconhece o pedido e não chama o parceiro de novo |
Regra de engenharia: nenhum pedido termina em erro silencioso. Ou ele avança, ou espera com o motivo à vista, ou vai para uma pessoa.
Troque o parceiro sem trocar o sistema
Fornecedor muda: o preço sobe, a API ganha uma versão nova, o serviço piora, aparece uma alternativa melhor. Quando as chamadas a um parceiro estão espalhadas pelo sistema, trocar de transportadora ou de gateway vira um projeto inteiro.
A saída é dar a cada parceiro um conector próprio: uma peça que traduz o que o sistema precisa (consultar, cobrar, emitir, avisar) para a API daquele fornecedor. O núcleo (pedido, etapas, regras, tentativas e histórico) não sabe qual fornecedor está do outro lado. É assim que desenhamos as integrações que entregamos: trocar de fornecedor passa a ser trocar um conector, e o resto do sistema não percebe a mudança.
Numa loja virtual, por exemplo, pagamento, frete e atendimento são três parceiros diferentes ligados ao mesmo pedido, como na LifeProductsBR, um dos cases que publicamos. Com um conector por parceiro, qualquer um dos três pode ser substituído sem mexer no pedido nem nas outras duas integrações.
O que medir antes e depois de mudar a integração
Sem medição do antes, nenhuma mudança comprova resultado. Antes de mexer, registre:
- Custo de chamadas pagas por pedido concluído. Quanto a operação gasta com parceiros para cada pedido que chega ao fim, e não para cada pedido recebido.
- Pedidos parados por etapa, e há quanto tempo. Olhe também os piores casos, e não só a média: um pedido esquecido há meses distorce a média e esconde onde o processo trava.
- Pedidos que esperaram um parceiro. Quantos foram, por quanto tempo e em qual integração.
- Pedidos enviados à análise manual por falha de integração. É o número que mostra se as novas tentativas estão funcionando.
Por onde começar
- Siga um pedido real, do envio à conclusão, e anote cada chamada paga: em que momento ela acontece e o que já se sabia sobre o pedido naquela hora.
- Liste o que pode recusar um pedido sem custo e confira se essas regras rodam antes da primeira chamada paga.
- Simule a queda de um parceiro em ambiente de teste. O pedido espera e retoma sozinho, ou se perde?
- Liste os parceiros e conte as partes do sistema que mudariam se um deles fosse trocado amanhã.
Mapear as integrações e mostrar onde elas pagam chamadas sem necessidade ou perdem pedidos é o diagnóstico que fazemos antes de propor qualquer desenvolvimento. Quando o problema está na passagem entre sistemas, o trabalho é de APIs e integrações. Quando a operação precisa de um sistema próprio, é de sistemas sob medida. A etapa anterior, a da captação, está no texto sobre onde o lead se perde entre o formulário, o CRM e o WhatsApp.
Solicitar o mapeamento das integrações da minha operação